



 新华报业网
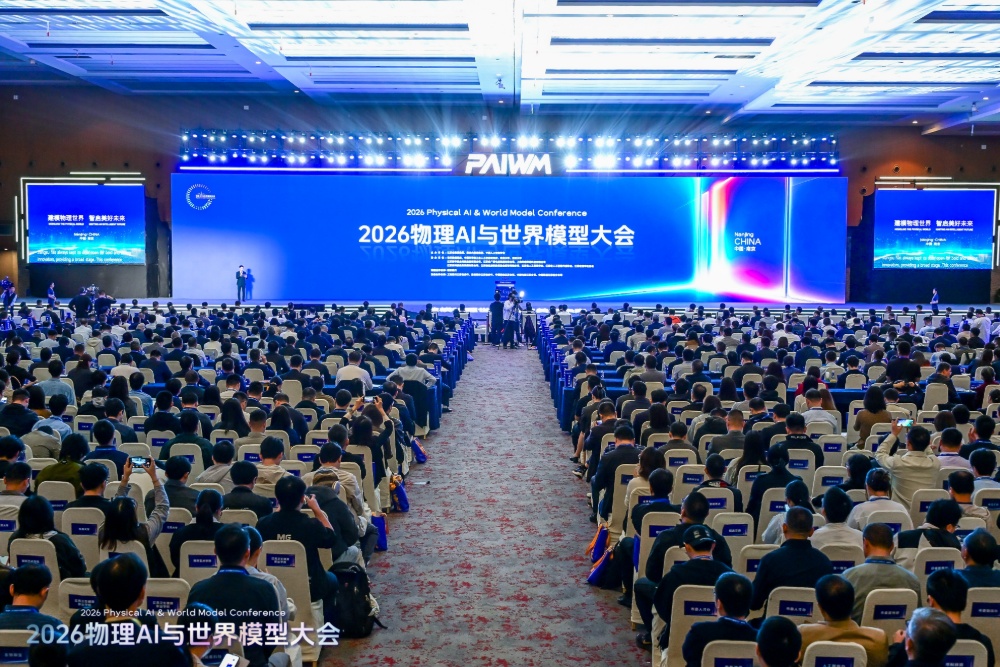
10月20日,以“建模物理世界·智启美好未来”为主题的2026物理AI与世界模型大会在南京启幕。图灵奖得主视频演讲、专家与企业家同台分享、国家标准预研启动、50亿元投资基金签约……大会给出的行业判断很明确:AI正从数字世界走向物理世界,世界模型是下一道必答题。
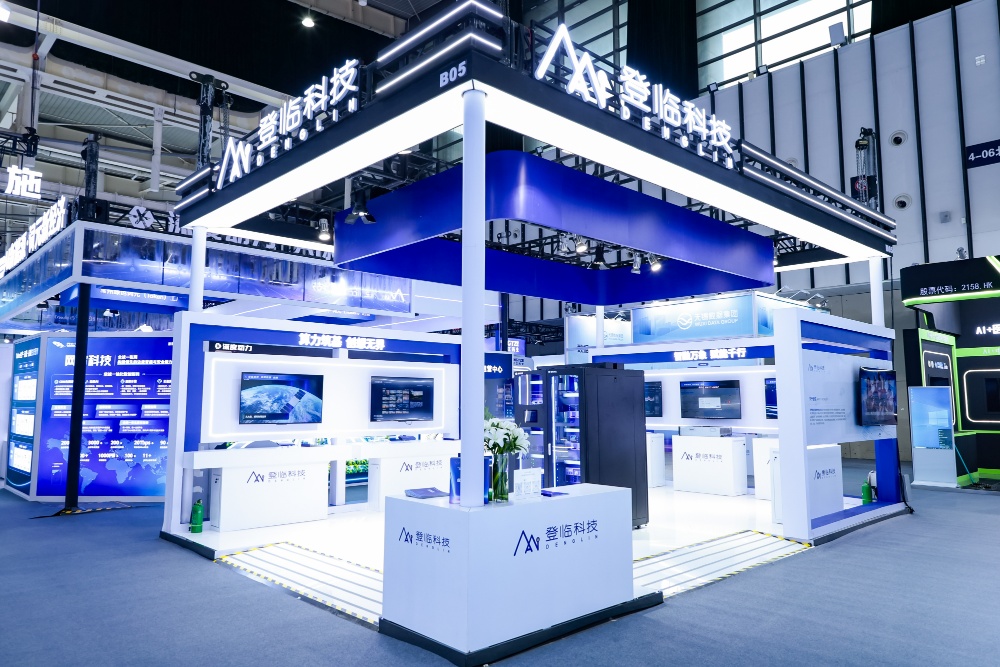
在这场汇聚全球前沿思考与江苏产业落地成果的会上,苏州登临科技股份有限公司(以下简称“登临科技”)把“登临紫金”智能算力服务器摆进了展区。登临科技2017年成立、2024年将总部迁至苏州,是江苏省唯一实现大规模量产的GPU企业,也是国内率先实现规模化商业落地的GPU企业,2024年至今销售收入持续快速增长。对做硬件的人来说,世界模型这道题落到纸面上是一组很朴素的算术:单位机柜能塞进多少算力,单卡能扛住多大显存,数据在芯片与显存之间搬得够不够快。
一颗GPU的“江苏拼图”
登临落地江苏,首先是一道产业链算术题。江苏并不缺半导体底子:南京有晶圆制造、服务器与EDA龙头,无锡领跑先进封装,苏州一地落户了全球前十封测企业中的六家。设计、制造、封测、光互连样样俱全,唯独通用GPU这颗“最贵、最硬的芯”长期缺位。2026年5月,登临首次以GPU企业身份进入江苏增资扩产资金的产业视野;8月又亮相无锡集成电路大会,与长电、盛合晶微等企业共同发布面向AI落地的解决方案。
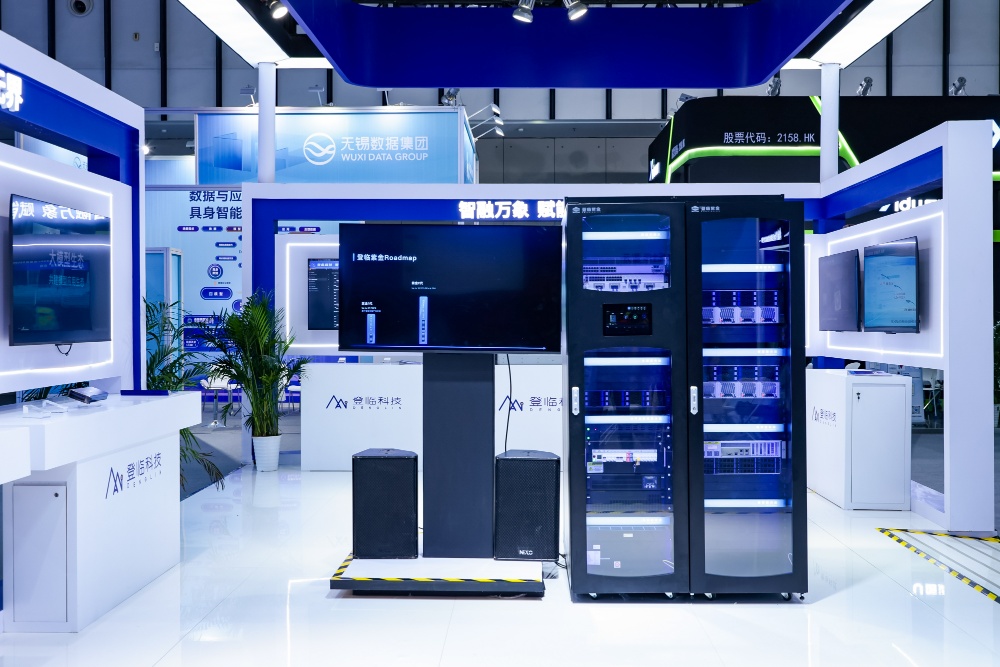
这一产业逻辑直接投射在展品上。“登临紫金”不是一颗芯片,而是一台超算节点。“我们的芯片型号包括Goldwasser、纳适等,这次展区展示的是KS系列芯片相关产品,对客户呈现的主要是GPU卡。”登临江苏AE负责人白云俊介绍,“登临紫金”采用单机柜48卡设计,整柜算力达到13.4P。“我们并不单纯追求更高的单柜卡数或理论算力指标,而是更加关注算力在实际应用场景中的有效利用,以及系统稳定性、部署成本和运维效率。通过自主GPU技术与江苏本地服务器、网络、存储等上下游企业的协同,我们希望打造既具备算力支撑能力,又能够满足行业实际需求的国产智算解决方案。”同时,节点部署了自主开发的服务器管理软件,面向政务、交通、安防、能源、教育、智能制造等关键行业的规模化智算场景,很大程度上填补了省内自主智算装备的市场空白。
一套架构的“错位突围”
当前,国内AI算力市场呈现多种技术路线并行发展的竞争格局,不同厂商依据自身技术积累和目标场景形成了差异化的产品定位。登临科技依托自主研发的GPU+(MinSky)架构,重点布局AI推理、计算机视觉及边缘计算,通过架构创新和软硬件协同探索国产GPU的差异化路径。据登临官方披露,GPU+在典型AI场景下的能效比可达竞品的3至5倍;公司董事长王晨辉曾在接受采访时称,使用成熟制程也能达到业界主流性能水平,并已适配DeepSeek、MiniMax、Kimi等主流大模型。
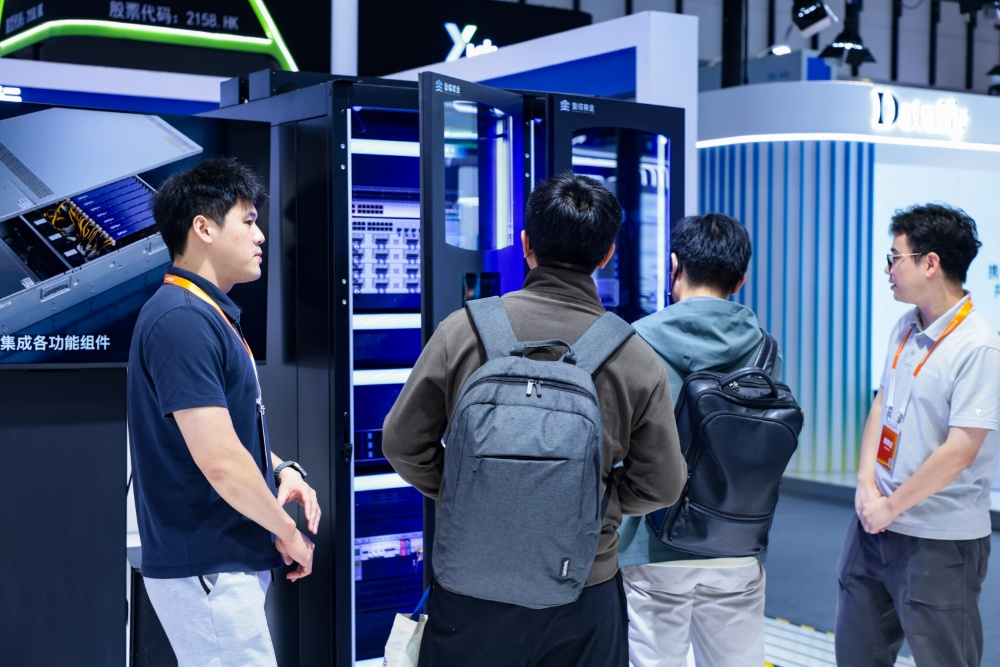
生态位的选择比架构参数更能说明问题。白云俊拆解了国内GPU的两条路线:国内AI算力芯片企业采用了不同的技术路线,各自在通用计算、AI训练、模型推理等领域形成差异化优势。登临科技依托自主研发的GPU+架构,在兼顾通用性的同时,重点提升AI推理与计算机视觉场景下的计算效率和能效表现。“涉及混合模型的AI应用,比如智慧城市、智慧交通、智慧工业、智慧医疗等场景,我们的卡能力比较强。一些国际及国内龙头公司可能在高密度大模型训练、超节点和多卡集群训练方面有生态位强项,而我们虽然也可以做训练,但业务重心放在AI推理上。”
国内AI算力市场具有广阔的发展空间,不同技术路线和产品可以根据应用场景形成差异化定位,实现优势互补、协同发展。据白云俊介绍,产品线上,KS58、KS38面向大模型推理,纳适系列单卡最高128GB显存;KS20系列走向边缘,典型功耗仅25W,用于工业质检产线和院内辅助诊断等敏感数据不上云的场景。
一台节点的“显存考题”
物理AI和世界模型对GPU提出了更加多元的要求。与传统大语言模型相比,世界模型往往需要处理视频、空间信息及连续变化的物理状态等复杂数据,不仅需要强大的计算能力,也对显存容量、数据传输效率和实时响应能力提出了更高要求。尤其在大规模部署场景下,如何兼顾算力密度、计算能效和系统长期运行的稳定性,成为衡量底层算力平台综合能力的重要因素。白云俊用一个展会细节说明了这种需求变化:“早些年大家看到我们的卡,第一反应是问‘能不能打游戏’;现在客户不仅关注算力,也越来越关注显存容量、软件兼容性和部署成本。这反映出市场需求正在从单纯关注硬件参数,向关注AI应用的实际部署能力转变。”登临紫金48卡、13.4P的机柜规格,以及纳适系列128GB单卡显存,指向的正是“用更少卡加载更大模型、降低卡间互联压力”的工程思路。
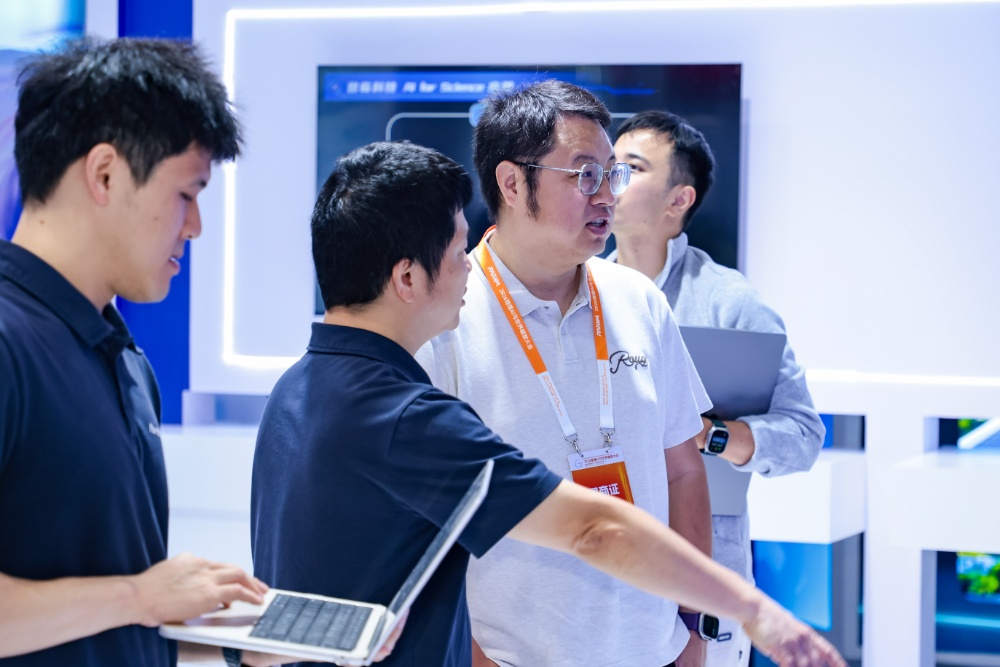
但这套底座要真正撑起物理AI的规模化商用,仍有需要回答的问题。世界模型的训练和推理对软件栈成熟度、算子覆盖度和集群稳定性的要求远高于单卡性能指标,而登临的GPU+生态兼容策略能否在真实客户的长周期使用中兑现“低迁移成本”的承诺,比任何展会演示都更有说服力。谈及物理AI落地节奏的判断,白云俊的理解也偏谨慎:“物理AI具有重要的发展潜力,但不同应用场景的成熟速度不同,从技术突破到规模化应用仍需要解决可靠性、成本和场景适配等问题。”
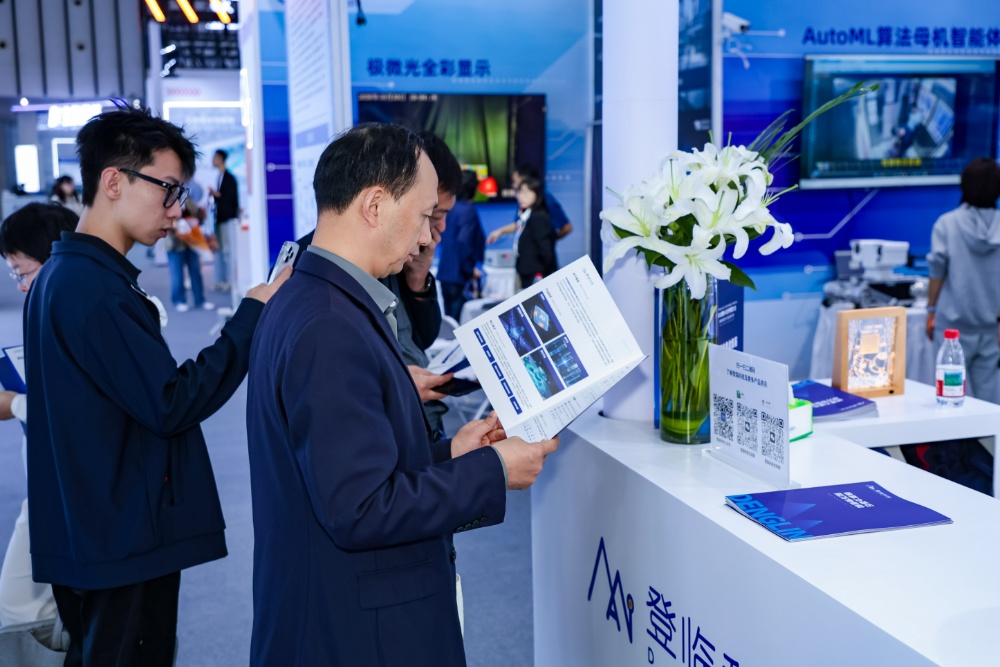
回到登临紫金的展台,48张卡安静地插在机柜里,指示灯明灭。它们单张拎出来,未必是这场大会上算力数字最高的那颗,但被放进同一台由江苏产业链托举的服务器里,跑着苏州公司适配的模型,服务着政务、工业、医疗场景中那些过去只能用英伟达卡来做的活。
这台节点的意义,不在于某一项参数压过了谁,而在于它证明了一件事:一颗通用GPU从设计、流片、封装到整机集成、模型适配、场景落地,可以在一个省域内跑完整个链条。实际上,国产GPU的突围,很少发生在聚光灯正中央。更多时候,它发生在一条产线的质检窗口里,一台医院办公室的边缘设备里,和一个机柜48张卡同时稳住运行的深夜里。
而物理AI的“开悟时刻”什么时候来?虽然没人说得准,但底座得先有人砌。
新华日报记者 杨晔





 Android版
 iPhone版